使用 RVC 制作 AI 翻唱
博主第一次做 AI 翻唱,于是记录一下全流程的 pipeline 以及自己的经验。
下面是效果,让 AI 绘名唱了一下我最喜欢的夜鹿曲子,就喜欢听铃果唱歌!
我用的 pipeline:
硬件设施
博主使用的是 Mac 和一台远程的 AutoDL 服务器,大约 1 元每小时:
GPU: RTX 2080 Ti *2 (22GB)
CPU: 12 vCPU Intel® Xeon® Platinum 8336C CPU @ 2.30GHz
RAM: 45 GB
之后的所有模型训练、推理工作都在服务器上完成,Mac 作为本地 ssh 连接和后期工作的设备。
自认为服务器的配置是相当足够应付这个工作的,训练模型的部分(200 epoches)大约在三小时能够完成,推理只需要 10 秒左右。
下面来介绍一下具体的准备素材、训练、推理之类的工作吧。
素材准备
准备一些训练用的歌曲素材,比如:
网易云下载的 ncm 文件转换成 mp3 可以用 ncmdump:
如果要从 b 站上爬,可以用 yt-dlp 解析和下载:
1 | |
下载之前可以看这个视频有哪些清晰度,音频也会显示出来:
1 | |
用 -f 参数指定想下载的就可以了。
环境配置
参考 prompt:
1 | |
最重要的就是不仅仅是要把代码和组件安装好,对应的权重和模型也要拉取下来,让 Agent 做就好了。5.6 Luna 也可以做好的工作。
UVR 分离人声
训练的链路是这样的:只有 Vocals 的 WAV 准备 RVC 训练集 训练模型 用只有 Vocals 的 WAV 推理。
那 UVR 就是把伴奏和 Vocals 音频分开的工具了,所以不仅仅是训练的时候要用,推理的时候也要用。
UVR 的工作效率很高,audio-separator[gpu] 也很方便 CLI 使用,但是后面的 UVR 只提供 WebUI 的话,就只能手调了。
切分数据集
训练前要用脚本切分数据集,具体的内容在上面的 GitHub 仓库里有。这个不能忘了。
RVC 训练
然后就是用 WebUI 训练了,可以用端口转发到本机来做,比如:
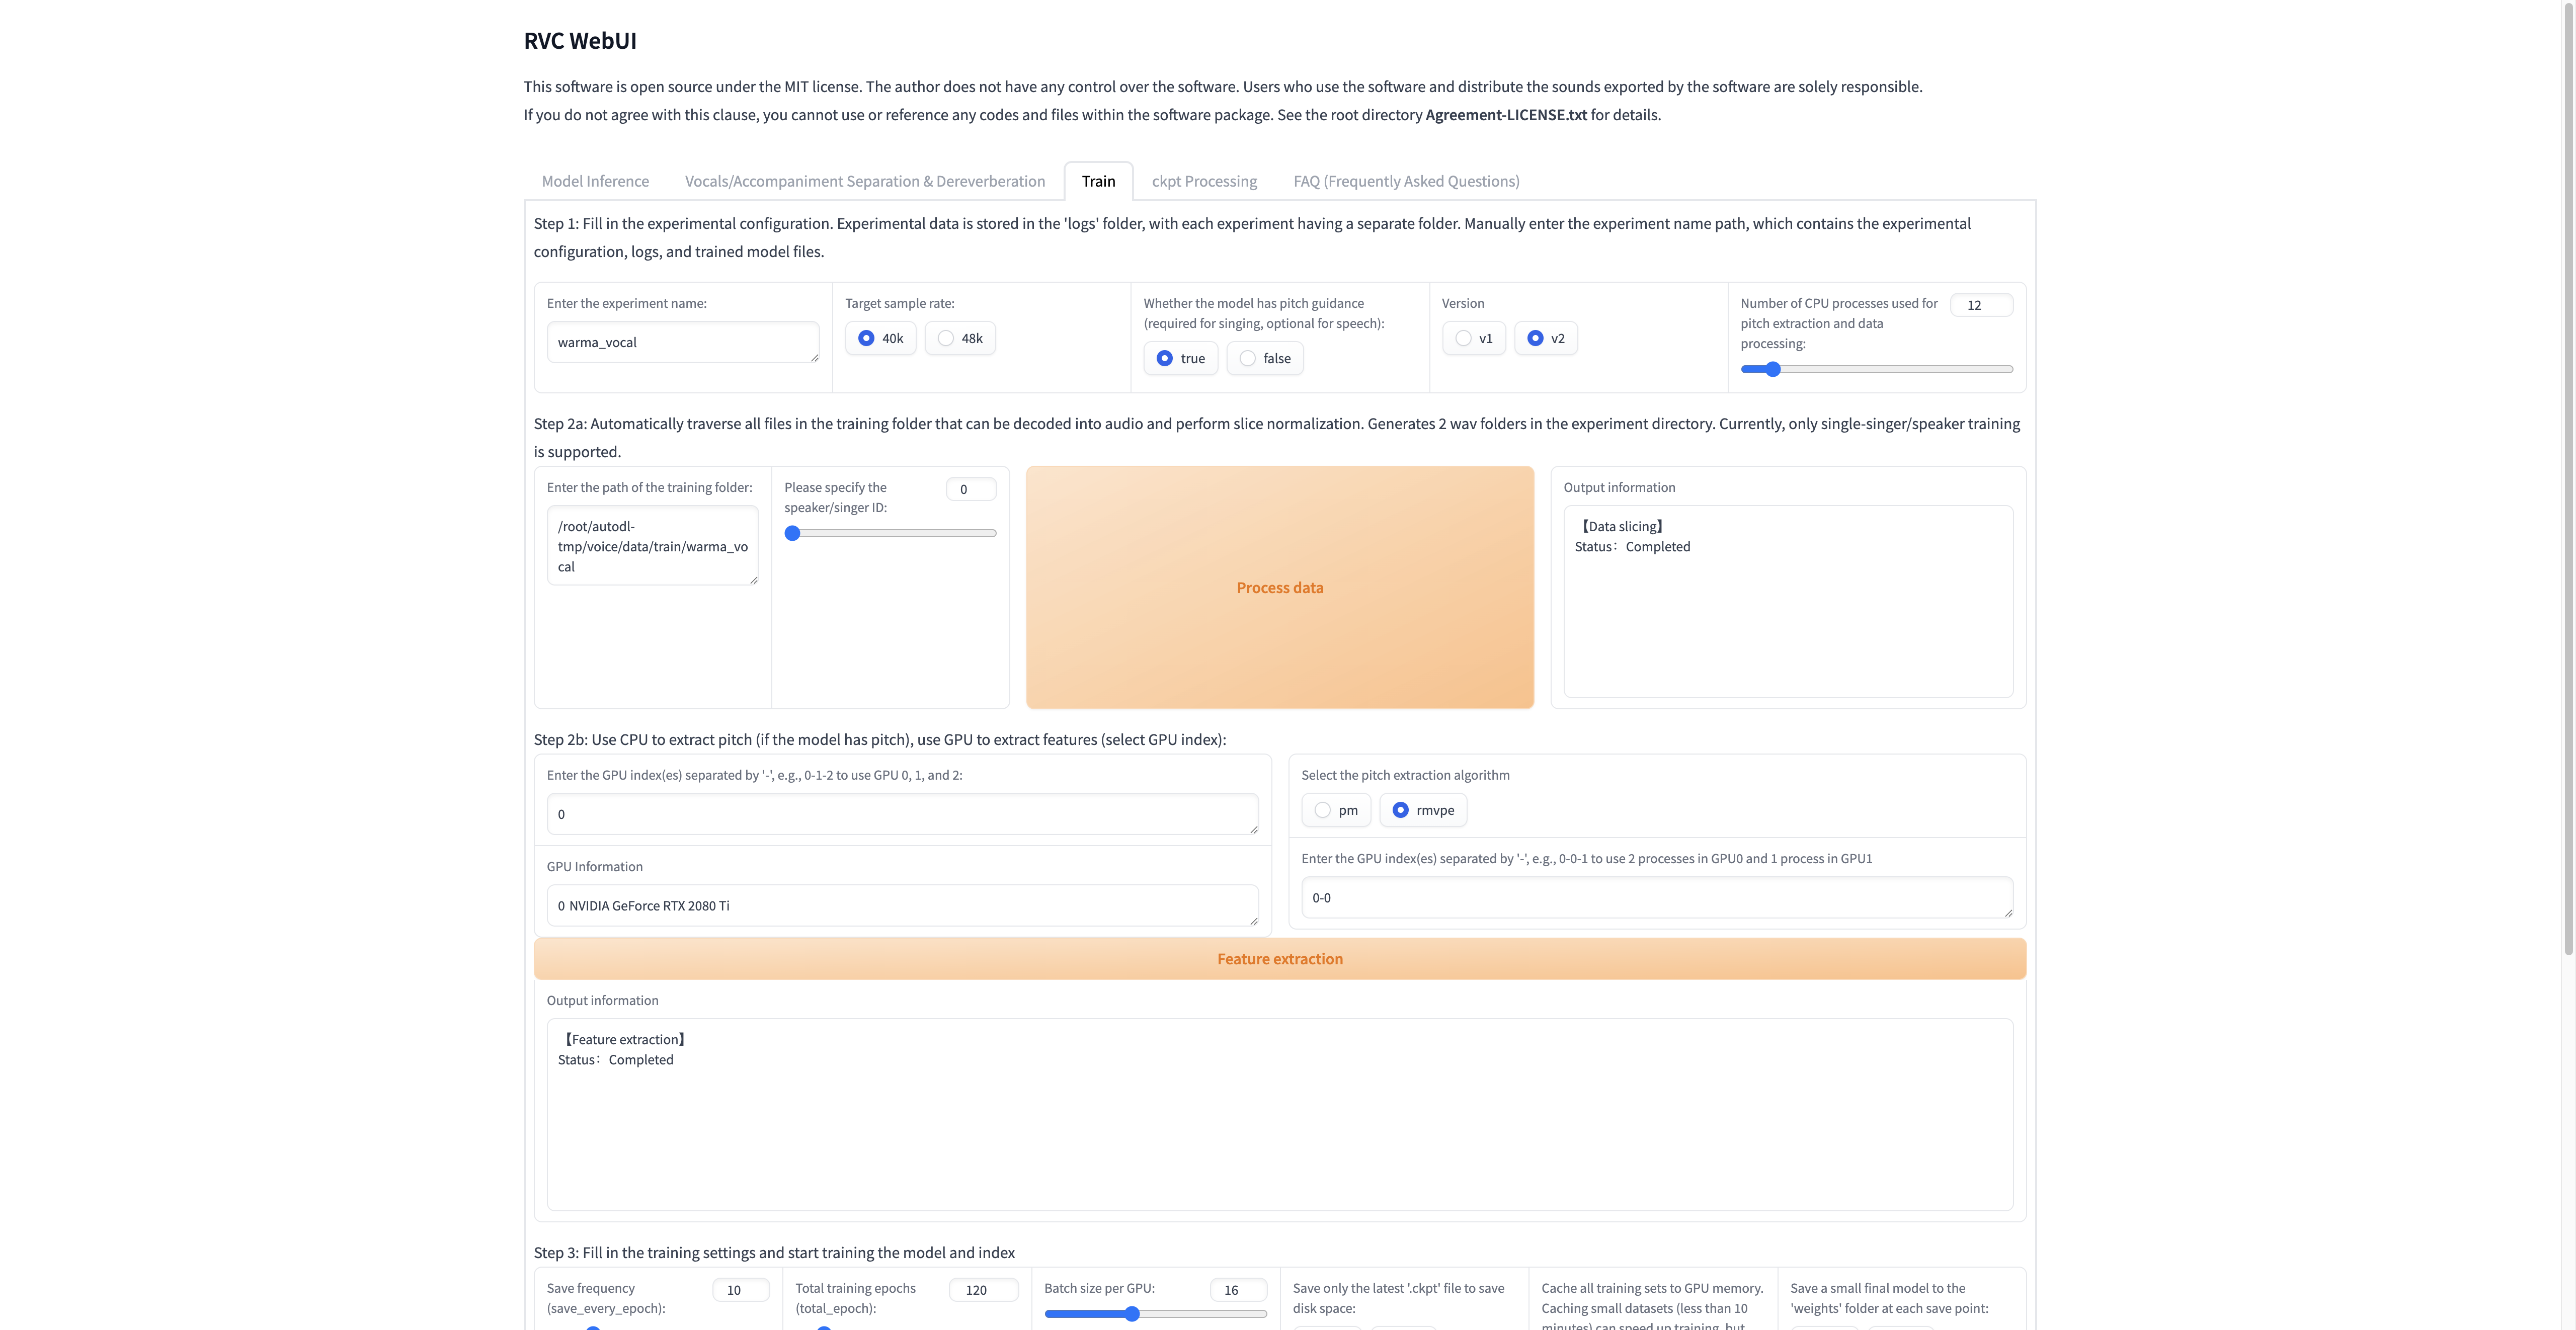
很傻瓜式,但是要注意一些路径问题,要不然很麻烦。填写内容可以参考:
| 表项 | 值 |
|---|---|
Experiment name | shinonome_ena_vocal |
Training folder | /root/autodl-tmp/voice/data/train/shinonome_ena_vocal |
Sample rate | 40k |
Version | v2 |
If using F0 | ✅ |
F0 method | rmvpe |
CPU threads | 8 |
GPU | 0 |
Batch size | 16 |
Save frequency | 25 |
Total epochs | 120[1] |
Cache data in GPU | ❌ |
Save a small final model | ❌ |
推理
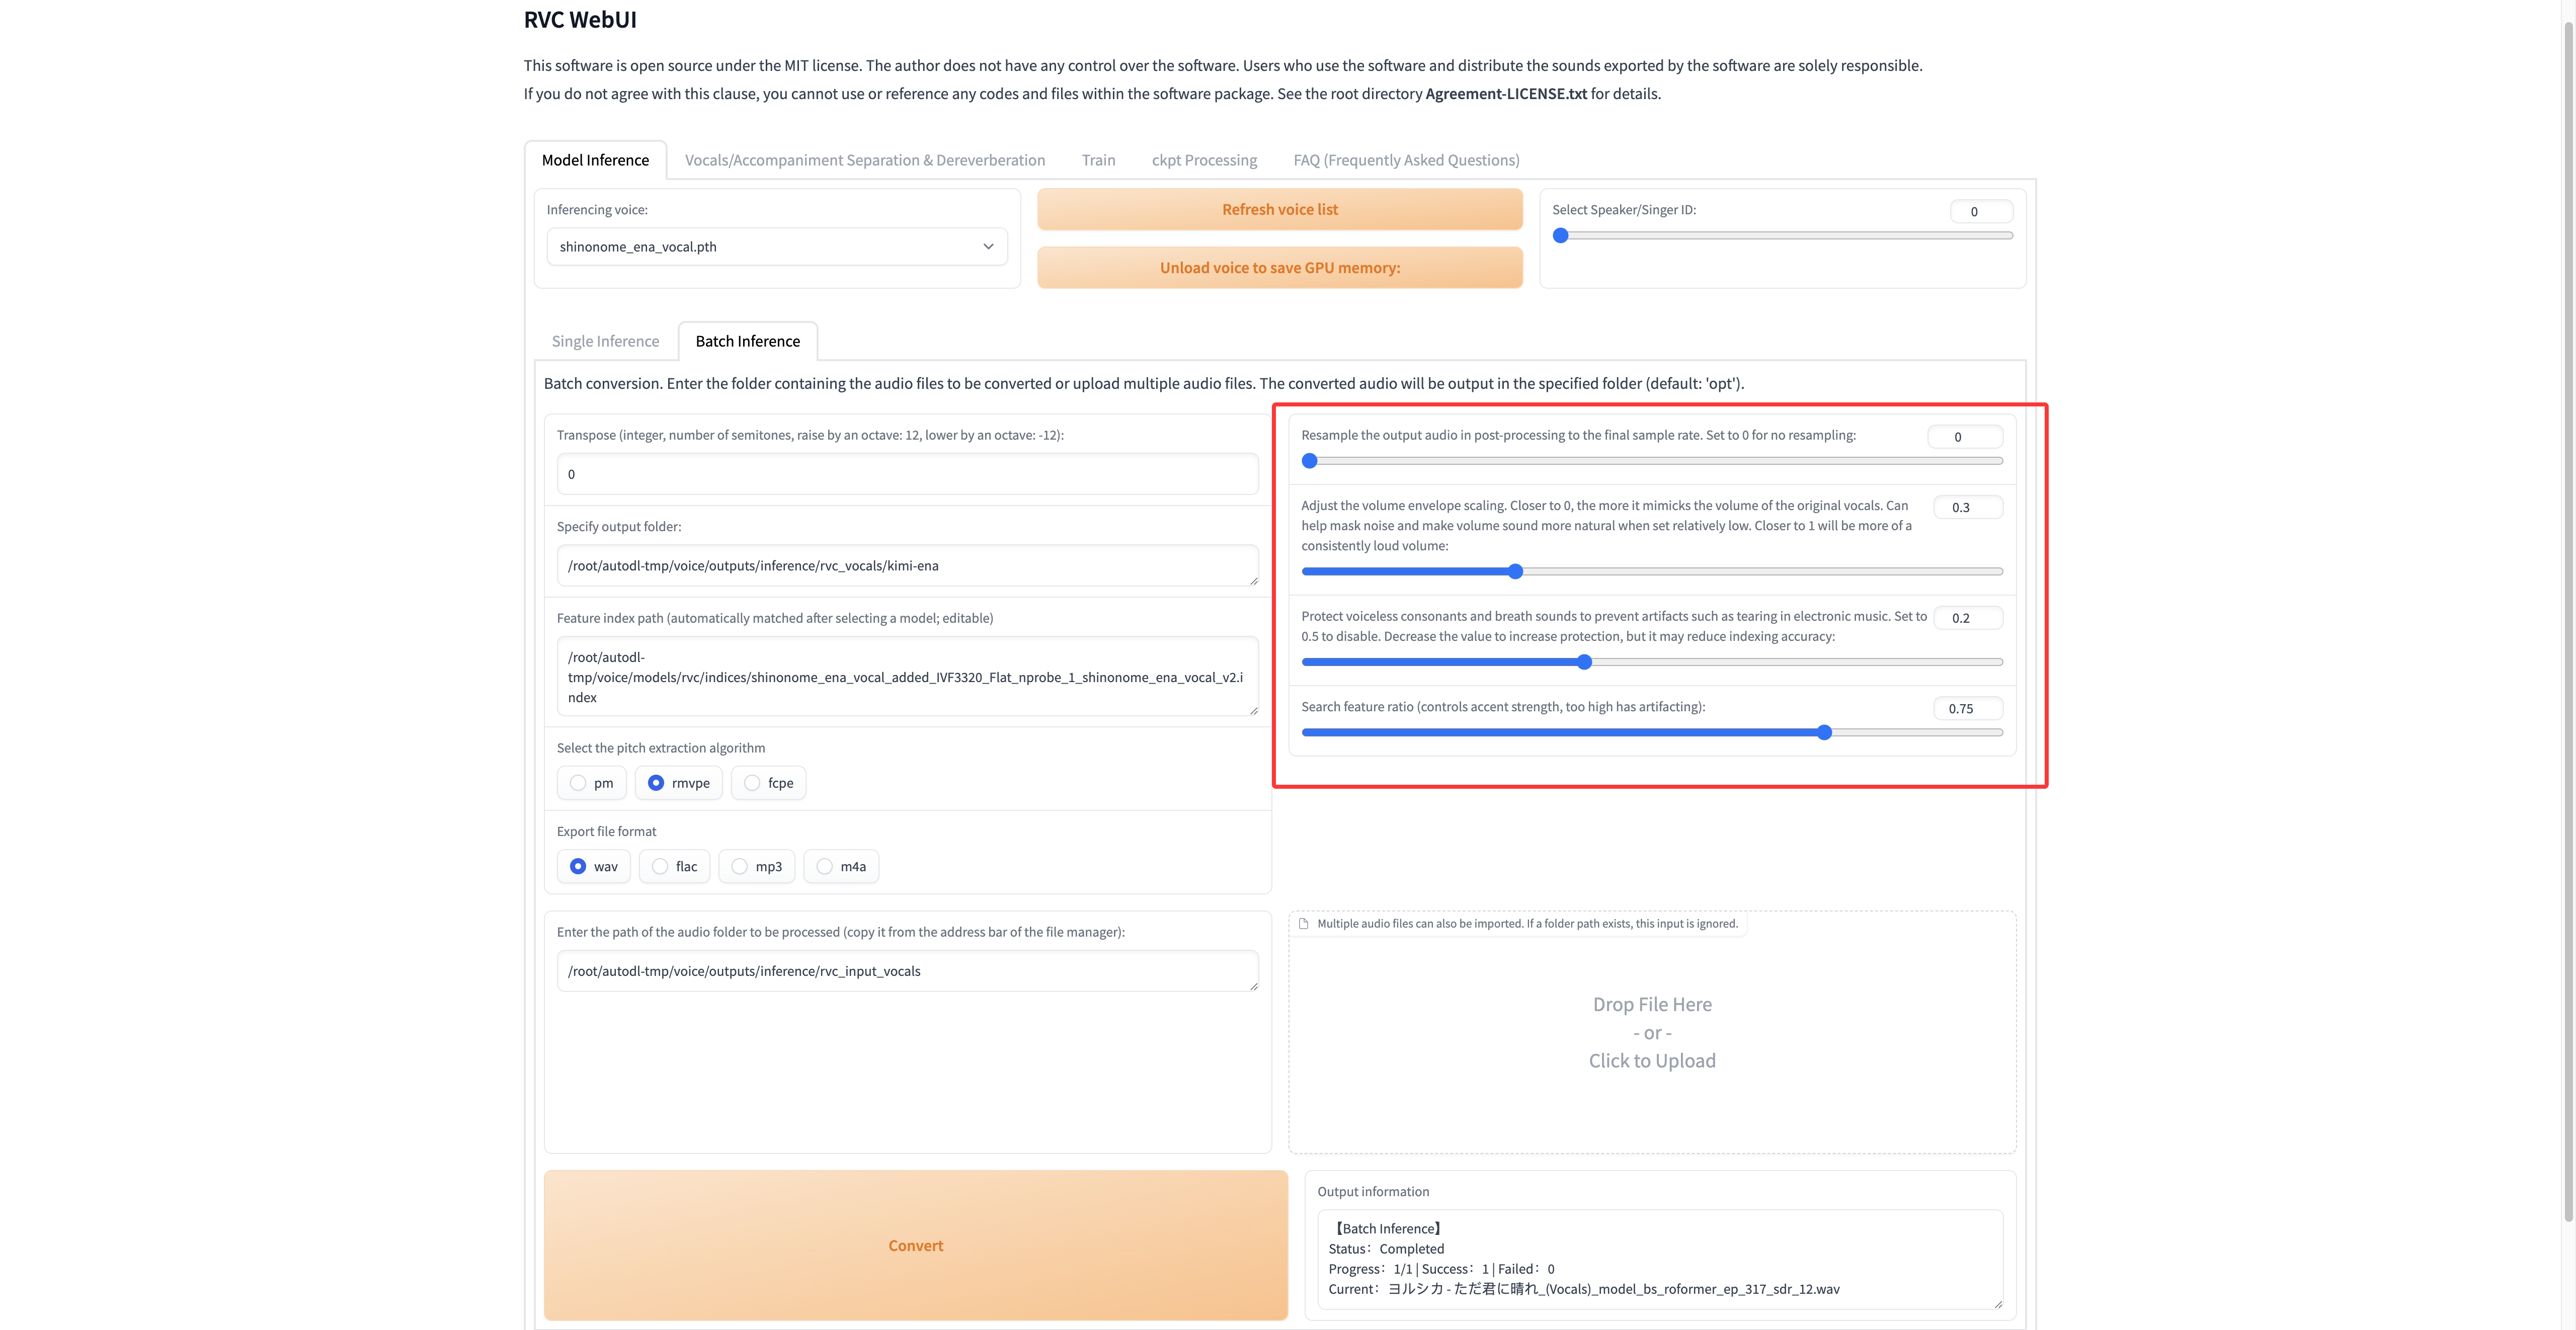
右边的这四个参数是最影响效果的,但是如果随便选的参数都能效果不错的话,那再调教影响应该也不大,我是听不出来。
推理速度很快,慢慢调参,听就是了。如果有破音 [2] 可以换成 fcpe。transpose 调的时候最好保持 0。
混音
输出的文件只有 vocals 的音频,那就可以在本地混音或者直接用 FFmpeg。到本地用 Logic Pro 混肯定效果最好吧可惜我不会用。